
某连锁超市的门店,工作日下午三点。一位顾客举着一件针织衫,问店员:「这个有我的码吗?」
店员低头在手持终端上翻了四十秒,抬头说:「系统显示有货。」两个人在货架前又找了五分钟,没找到。系统没坏,货也没丢,只是系统里的那个数字,比货架上发生的事晚了 15 到 30 分钟。
这是零售这一行最日常的一天。零售 FDE 的入场方式最简单也最有效——到门店做一天店员。穿上工服,站在货架前,帮人找商品、回答库存问题、处理退货。
一天下来,你会撞见三件跟后台报表完全对不上的事。这三件事,决定了零售 AI 该从哪里切进去。
零售 AI 的入场券
不在算法,在把「后台的数字」和「货架上的事实」对上。而这一步做完,真正难的部分才开始——大促零点,流量是平时的 50 倍,推理队列排到 8 秒,客户早就关掉了页面。
本文你会看到
01 站一天柜台,比看三个月报表管用
02 零售的流量不是均匀的,是脉冲的
03 只讲一个场景:把「为什么推荐」说清楚
04 零点崩了一次,才明白降级不是预案
05 三条判断,和一段能直接抄的 Prompt
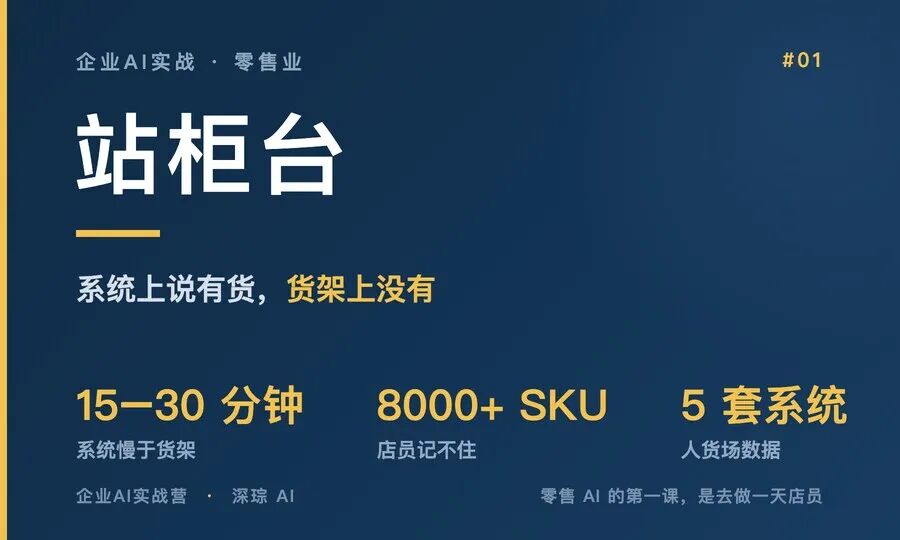
第一件事:系统说「有货」的时候,你最好自己去货架看一眼。店员的手持终端、门店 POS、后仓系统,三边的数字对不上是常态。手册给的量级是——系统数据与物理库存之间存在 15 到 30 分钟的延迟,促销日和大补货日之后更长。你看到的那句「有货」,是一刻钟以前的货架。
第二件事:一个店员答不上顾客的三个问题,不怪他。一家中型门店在售的 SKU 就有 8000 多个。能不能机洗、两个尺码差几厘米、跟哪条裤子配,顾客连着问三个,店员能答上一个已经算熟练。答不上来就不买——这不是服务态度问题,是知识供给问题。
第三件事,也是最反直觉的一件:门店里最耗时的动作,不是卖货。是找货,和退换货那套流程。卖货有提成,有人愿意干;找货和退货是纯消耗,谁也不愿意干,可它俩吃掉的时间最多。
这三件事摆到桌面上,方向就自己浮出来了:实时库存感知,让系统追上货架;商品知识库,让店员答得上;退换货自动化,把纯消耗的流程接走。
但先别急着挑场景。零售这一行还有一条更硬的约束,它比任何技术选型都更能决定项目的生死。
而且这条约束平时几乎感觉不到它存在——只在真实的大促日,才会一次性露出来。
所以零售 AI 的第一步不是把模型调准,是把现场那一米的信息差先补上。
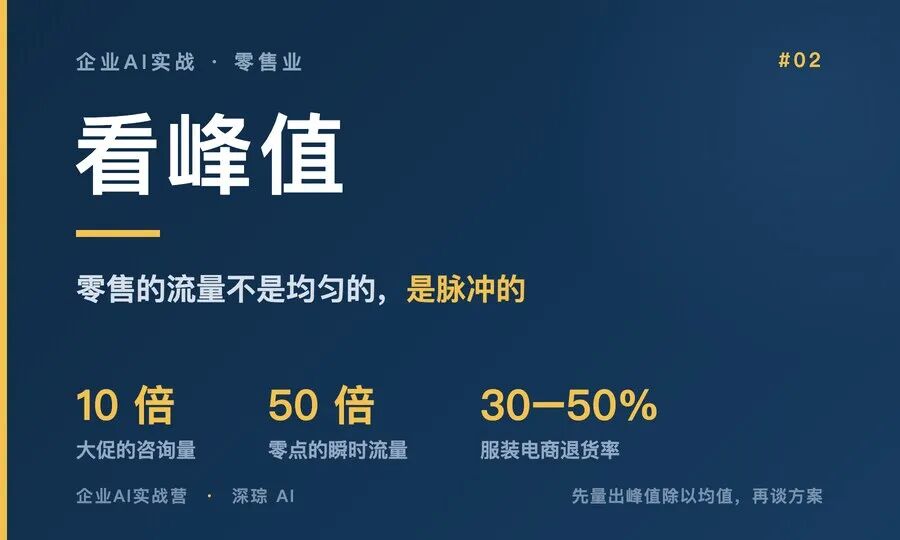
零售 AI 的第一条硬约束不是算力,也不是模型,是节律。这一行的流量从来不是均匀的——日常一天,一家中型电商 100 个客服足够了;大促当天,咨询量会涨到平时的 10 倍。
而这 10 倍不是摊在 24 小时里的。它是一个尖峰:0 点整,所有人同时点下付款,同时来问「我的订单到哪了」。零点那一分钟,流量可以是平时的 50 倍。
任何按「平均负载」设计的系统,都会在这一分钟崩。而这一分钟,恰恰是你全年最不能崩的一分钟。
第二条约束更隐蔽:数据是散的。人、货、场三个维度的数据,分散在 CRM、ERP、POS、电商平台、社交媒体至少 5 套系统里。能真正打通的零售企业,少之又少。
剩下两条是这一行的固有损耗。一头是退货的「预期鸿沟」——服装品类的电商退货率高达 30% 到 50%,短视频和直播电商更高;而退货的首要原因不是质量,是「与预期不符」:图上模特穿着好看,拿到手颜色差了两度、面料不是想象的那样。另一头是库存的牛鞭效应——从供应商到区域仓到门店,每一级都在「以防万一」地多备货。某连锁超市的数据是,25% 的货架空间被周转率低于行业平均的「僵尸 SKU」占着,而这些 SKU 贡献的营收不到 5%。
把这四条摆在一起,选场景的标准就清楚了:要挑一个既吃得住峰值、又真的能减少损耗的场景,而不是挑一个听起来最智能的场景。
手册在这一章给了三个场景:超个性化推荐、智能库存、智能客服。铺三个就散了,这里只讲透一个——推荐。因为它同时压中了上面两条最硬的约束:它吃峰值,也真的能减少损耗。
传统推荐系统回答的是「看了 A 的人还看了 B」,本质是统计相关性。AI 时代的推荐要回答的是「为什么推荐 B」——那是因果推理。这两句话的差别,就是推荐位转化率还能不能再往上走一截的差别。
手册给的是一条多模态链路:客户上传一张自己的穿搭照片,视觉模型提取风格标签(韩系简约/美式街头/日系通勤)和体型特征,向量检索库存里风格最匹配的商品,最后让大模型对排序结果做一层「推理层」处理,为每件商品写一段推荐理由。
关键是那段理由长什么样。不是「你可能喜欢这件衬衫」,而是「这件衬衫的领型和您上个月买的那件西装外套很配;上次您买的西装是深蓝色,这件浅蓝条纹衬衫可以做内搭」。后者有效,是因为它给了一个「为什么要买」的理由——推荐系统第一次不是在猜,是在解释。
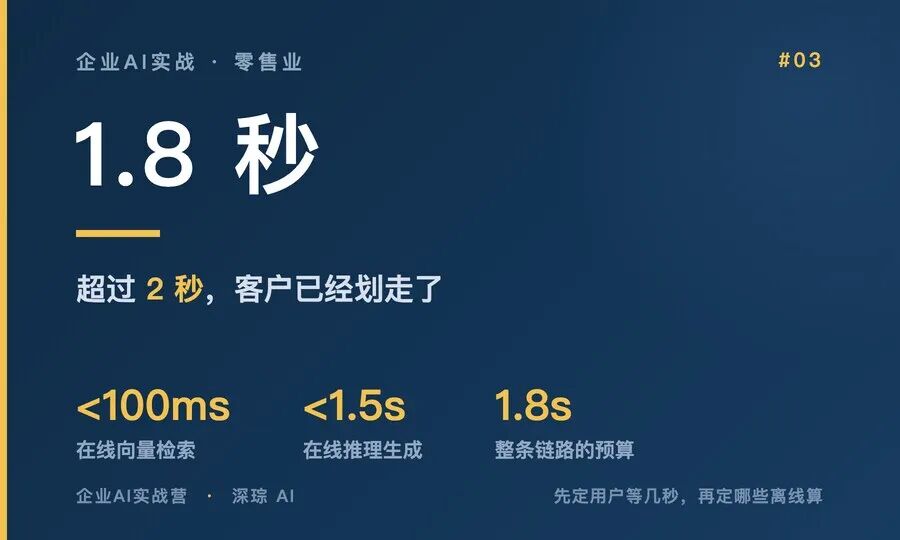
但整条链路有一条生死线:延迟。链路超过 2 秒,客户已经划走了。手册给的解法是把推理拆成在线和离线两半——向量检索(小于 100 毫秒)和推理文本生成(小于 1.5 秒)放在线上;风格标签提取、体型特征分析,在客户上传图片那一刻就离线算好。整条链路压在 1.8 秒以内。
效果的量级是这样:某服装品牌上线 6 个月,推荐位转化率比传统协同过滤提升 35%,退货率从 42% 降到 34%。
品牌方最满意的其实不是转化率,是退货率。每降低 1 个百分点,省下的逆向物流成本大约等于年营收的 0.3%——这笔账,比多卖几件衣服更实在。
到这里,方案看起来很完整了。但它是按「平均流量」设计的,而零售的流量,从来不是平均的。(所以真正的学费,在后头。)
推荐系统上线第一个月,点击率确实高。第二个月开始往下掉。
原因不是模型退化了,是它太准了。一个用户搜过一次奶粉,接下来推荐流里全是奶粉、尿布、婴儿辅食——他再也看不到别的品类。推荐变成了信息茧房:它把用户关在昨天的偏好里。
修法是在排序里加一个「多样性因子」:强制在 Top 10 里混入 2 个跨品类商品。这 2 个不是随机挑的,是按「买了 A 的人也买了 B」的跨品类关联规则来的。结果是点击率微降 2 个百分点,客单价反而涨了 15%——因为用户开始跨品类买东西了。
但真正贵的一课,在双 11 零点。
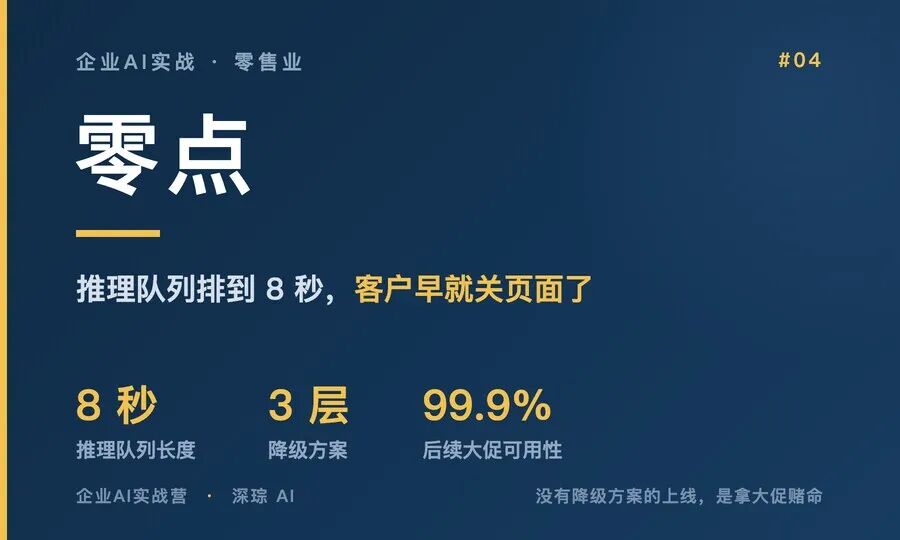
0 点整,流量是平时的 50 倍。AI 推理队列排到了 8 秒。8 秒是什么概念——客户早就关掉页面了。事后复盘,问题出在一个假设上:我们假设流量是均匀分布的,而实际上双 11 的流量是脉冲式的,0 点整是一个巨大的尖峰。
解法是三层降级,一层比一层狠。
第一层,预计算——双 11 之前,把所有用户的推荐结果预先算好,缓存到 CDN 上。
第二层,限流——推理队列一旦超过 3 秒,自动切回「非个性化推荐」,也就是热销榜、新品榜。
第三层,关掉推理层——极端情况下只做向量检索、不做大模型推理,延迟回到 100 毫秒以内。
这套方案在后续的大促里保住了 99.9% 的可用性。手册在这一章还记了第三个坑,它不是系统问题:同一个 SKU,在电商平台叫「2025 春款韩版宽松针织衫 V 领」,在 ERP 里叫 NSW-25S-K101,在门店 POS 里只有一串条码。要把这三个名字打通,靠的不是 AI,是商品主数据治理——一份枯燥、但一步都不能跳的基础工作。这一步不做完,前面所有关于智能的讨论都是空谈。
把上面全收成三条判断。第一条关于验收线:零售 AI 的第一条验收线不是准确率,是延迟预算。先定「用户最多等几秒」,再倒推哪些必须放线上、哪些必须离线算完。顺序反了,模型再准也没用——没有人会为了一个 8 秒的推荐等下去。
第二条关于降级:降级方案不是应急预案,是设计的一部分。一个没有三层降级的上线方案,等于把大促的生死交给队列长度。这条不只对零售成立——凡是流量有尖峰的业务,都成立。
第三条关于前置工作:匹配之前先统一口径。同一个 SKU 三个名字,再好的推荐也只是在一堆错的东西里挑。这一步枯燥、费时,但它是所有智能的前置条件。
手册每章末尾都附了一段可以直接用的 Prompt,零售这篇是「客服分流 Agent」。推荐那条线要按你自己的数据写,客服这块可以直接抄——它也是零售 AI 里最快见效、风险最低的一块。整理成能直接复制的版本:
客服分流 Agent(可直接复制)
意图识别:把客户消息归到订单查询/退换货/产品咨询/投诉/其他,五类里挑一类。
情绪打分:给这条消息的情绪打 1 到 5 分,依据是感叹号密度、否定词频率、有没有威胁性语言。
路由决策:订单查询和退换货在情绪 3 分以下交给 AI;产品咨询去查商品知识库;投诉且情绪 4 分以上,直接转人工,附带情绪预警、问题摘要和历史对话。
输出格式:按 JSON 返回 intent/sub_intent/sentiment/target_node/summary 五个字段,不要额外解释。
保守兜底:如果意图判断不出来,默认转人工客服。宁保守勿冒险。
这段 Prompt 里有两处设计不是技术活,但最值得学。一处是情绪先于意图——客户连发三个感叹号来问物流,问题再简单,也该转人工,而不是让 AI 上去灭火。另一处是退换货必须守住政策:7 天无理由就是 7 天无理由,不会因为客户「苦苦哀求」就破例。一个会通融的客服 Agent,比一个答不上来的更危险。
还有一条是成本账:查订单、查物流轨迹都是纯 API 调用,不需要大模型参与——用 LLM 去做「查快递」是杀鸡用牛刀。真正需要接知识库的是产品咨询,而且必须准:AI 说一句「可以机洗」、标签上印着「只能干洗」,这一单就直接变成退货。
本文行业框架与场景拆解,来自公开行业手册《FDE 实战案例集:16 大行业落地拆解》。文中数字为该手册给出的参考口径,非深琮实测、不构成任何效果承诺。判断标准与自有项目对照部分,为深琮观点。
别问推荐准不准,问零点那一分钟它还站不站得住。
回到开篇那家门店——店员答不上的那三个问题,和推荐位答不上的那三个问题,其实是同一个问题:系统里有的,和现场要的,对不上号。
这周先做一件事:
三样写全,缺一样先别上
把峰值量出来:大促零点前后的 QPS 和咨询量,找运维要一天的真实曲线,别用平均值。
把预算写死:用户最多等几秒,写成一个数字,发到群里,让所有人认这个数。
把降级写进设计:队列超过几秒切什么、极端情况关什么,三层全部提前定义。
这三样凑不齐,先别上大促。
晚一轮的代价不难算:大促一年就那么几次,崩一次,损失的是整整一年的增量。而这一年里,对手的推荐位已经帮他把老客户的品类拓宽了一轮。
你们家的推荐位,大促零点扛住了吗?是提前预计算,还是当场限流?
评论区写下来。
转给那个正在为大促技术方案拍板的同事,比收藏有用