
模型选完了,Agent 还是上不了线,问题往往不在模型。少的是它脚下那台计算机
跑不跑得动、关不关得住、停下来还烧不烧钱。FDE 交付的东西,正在从一套提示词,变成一台机器。
过去两年,客户问 FDE 的问题很固定:用哪个模型,提示词怎么写。
现在问题变了。它能碰哪些数据?代码在哪跑?跑飞了谁负责?断了能不能接上?
这四个问题,一个都不是模型问题。
本质上给 Agent 使用的一台计算机。
——阿里云智能集团容器、沙箱研发负责人 易立|据机器之心报道
这台计算机不好造。它得同时满足三件互相打架的事:要放得开——能跑代码、读文件、开浏览器;又要关得住——不许碰不该碰的东西;还得撑得住——跑到一半停了,回头能接着跑。
为什么这件事突然变重要了?因为 Agent 干的活,从「答一句话」变成了「干一件事」。
答一句话用不了几毫秒。干一件事可能跑几个小时,中间要等模型返回、等外部接口、等人工点确认。整个任务的生命周期,跟它真正在算的时间,早就不是一回事了。
本文你会看到
01 模型对了,活还是干不下来
02 这台计算机要过三关
03 给一万个一模一样的房间
04 上线以后,钱花在「等」上
05 FDE 该带走的一条判断
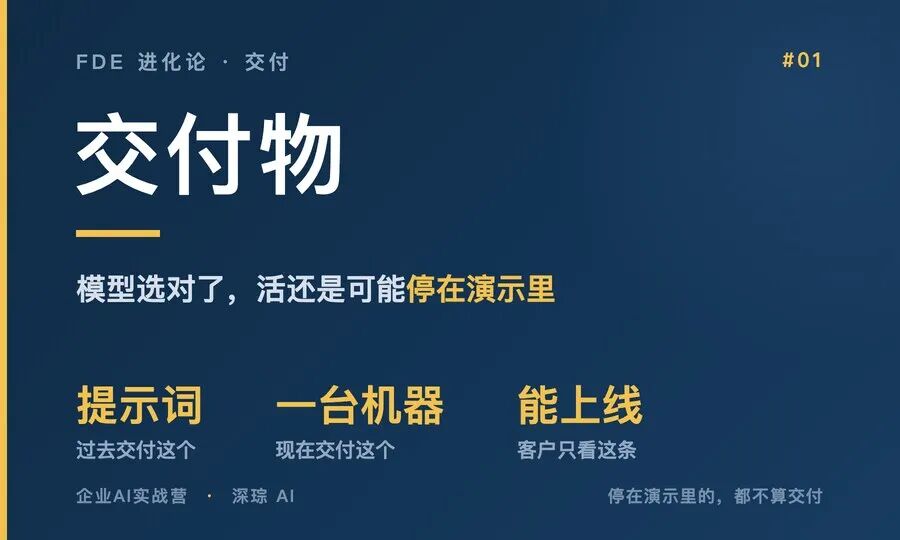
先说一个很常见的现象。
同一套模型、同一份提示词,在演示里跑得漂漂亮亮,一到客户环境就趴下。
多数人的第一反应是模型不够强。但你去现场看,卡住的地方往往很土:环境里缺一个依赖、它读不到那份文件、它访问不了那个系统。
模型是脑子,环境是手脚。脑子再聪明,手被绑着,活还是干不下来。
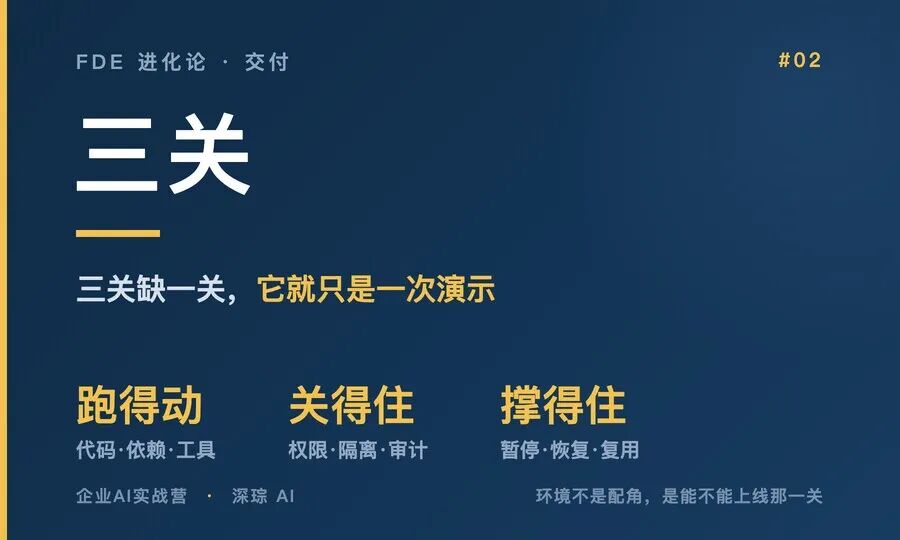
把「给它一台计算机」这句话拆开,就是三关。
第一关,跑得动。环境里得有代码、依赖、工具、浏览器,Agent 想调什么调得动,不用你临时去装。
第二关,关得住。它能访问哪些数据、能连哪些系统、能发哪些请求,边界得提前划死;几个任务同时跑,互相之间不能串。
第三关,撑得住。任务不是一口气跑完的,中间会停。停了之后的状态要存得下、接得上,还不能把资源一直占着。
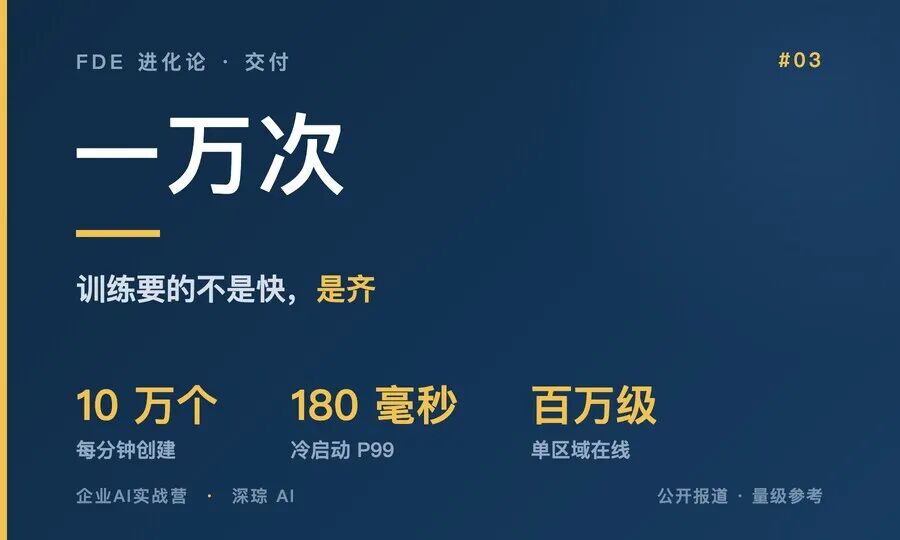
训练 Agent 是另一回事,要求跟上线几乎相反。
它要反复试:写一版方案、跑一遍、拿到分数、根据分数再改。这个过程一次要跑成千上万遍,每一遍都关在一个独立环境里。
这里的关键不是快,是齐。所有环境必须从同一个起点出发——不然你比出来的分数,自己都不信。
所以环境还得能存快照、能复制、能重放、能重置。同一份初始状态,分出几十条不同的路径去跑,这是把训练成本压下来的关键。
工程上的数字很直白:每分钟创建十万个沙箱,单个区域能同时在线百万个;冷启动 P99 小于 180 毫秒,热启动 P99 小于 20 毫秒。
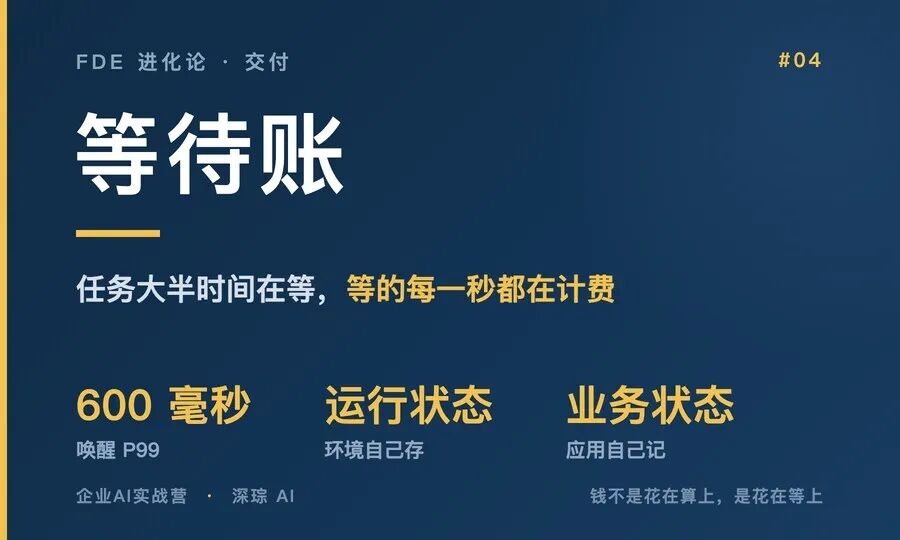
上线之后,账本换了算法。
Agent 干一个任务,大部分时间不在算,在等——等模型返回、等接口响应、等人工确认。这段等待里,如果它还占着满配的 CPU 和内存,你就是在替「等」付钱。
所以要能休眠、能唤醒:把状态存下来、把 CPU 内存放掉,任务回来了再接着跑。深度休眠的唤醒 P99 低于 600 毫秒。
这里有个坑,第一次做的人几乎都会踩:运行状态和业务状态是两码事。
环境能替它存住自己的内存、文件和进程;但任务做到第几步、写了哪张表、给外部系统发过什么请求——这些得你自己的应用记。两边不分开,环境一恢复,业务上下文就断了,人还得从头讲一遍。
这一整套东西,客户不会自己搭,也不该自己搭。
它属于云厂商的基础设施层。FDE 要做的不是造它,是在方案里认出它、用对它,并且提前告诉客户,认下它之后会带来什么。
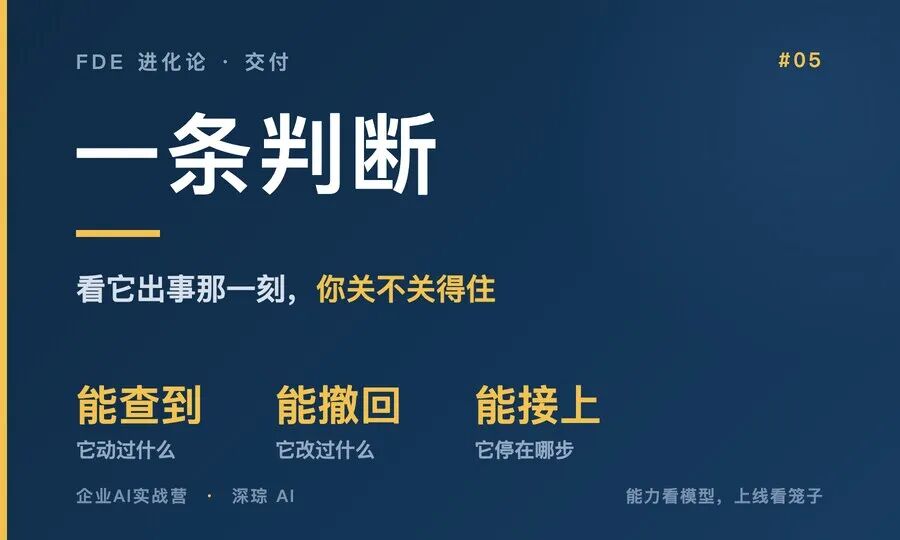
带走一条判断:看一个 Agent 能不能上线,别看它演示的时候多聪明,看它出事的那一刻——你能不能查到它动过什么,能不能把它关回去,能不能让它接着跑下去。
模型决定 Agent 想多远,执行环境决定它走多远。
这周先做一件事:
四件事,这周就能开始
把交付清单过一遍,把「环境」这一行加上去
问客户三个问题:它能碰哪些数据、代码在哪跑、断了谁接
把「等」的时间单独算一笔,别让它按满配占着资源
方案里把环境边界写清楚,比多写一页模型选型有用
晚一步的代价不难算:环境这一层,客户在会上问起来你答不上,下一轮方案就是别人写了。
你手上那个 Agent 项目,是卡在模型上,还是卡在环境上?评论区写下来。
转给你身边那个正在做 Agent 落地的交付同学,比收藏更有用