
先说一句结论
SAP 的 CEO 自己说,光靠一个大模型,连仓库都管不了。他们做财务结账智能体,AI 已经能干到 93%——但审计师不会签字。
本文你会看到
01 93% 那道坎:差的那 7%,不是性能
02 为什么一个大模型管不了仓库
03 先要清理的,是客户自己的房子
04 省钱的招不是限额,是换模型
05 员工问的不是累不累
一家做 ERP 做了五十年的公司,最近自己承认了一件事。
SAP 的 CEO 克里斯蒂安·克莱因,在 10 月 1 日首播的一期播客里说了一句话:只用一个大模型,没办法运营仓库,也做不了财务结账。
SAP 是欧洲最大的软件公司,管着全球大量企业的财务、供应链和人力系统。这句话从一个卖 AI 的 CEO 嘴里说出来,分量不一样。
更有意思的是他给员工的比喻。他在全员大会上放了一座山:SAP 已经爬过了「云」这座山,现在要爬「AI」这座山。山上有一道坎,他给了一个具体的数字——93%。
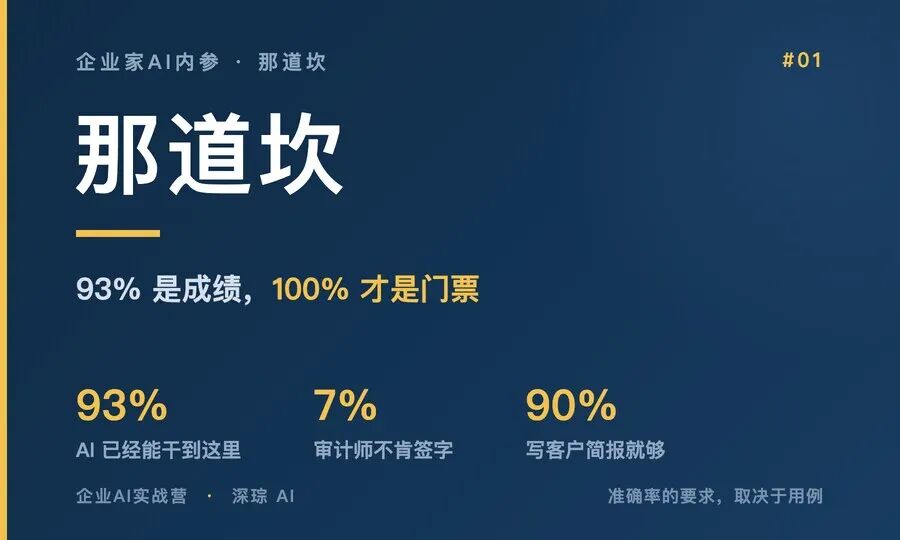
SAP 做了一个财务结账智能体。克莱因说,AI 已经能理解业务了,但准确率大概只有 93%。
93% 放在大多数场景里是好成绩。但财务结账不行。
因为审计师在公司发布财务结果之前,要逐项核对。偏差 7%,这份结果就过不了关。财务结账要的是经过认证的、100% 的准确率。
他判断这道坎几个月内能跨过去,但有个前提:针对特定任务。SAP 接下来要做的供应链优化智能体,他估计还要 8 到 9 个月。
这里有个更值得老板记住的细节:不是所有场景都要 100%。
克莱因出差时,会让 SAP 的 AI 同事 Joule 写一份客户简报。他说 90% 就够用,95% 同样可以接受。因为这件事原来是一群人坐在办公室里,为每一次客户拜访准备材料。现在 SAP 的数据本来就在系统里,公开信息交给大模型去理解。
所以真正的分界线不在「AI 准不准」,在于你把这个活儿归到哪一类——它错了,要不要有人签字。
「软件末日」的说法流行起来以后,克莱因的第一反应不是反驳,是去问产品组合团队一个问题:我们产品线里,哪些方案可以被「用提示词做软件」轻易复制掉?
答案很快就出来了。
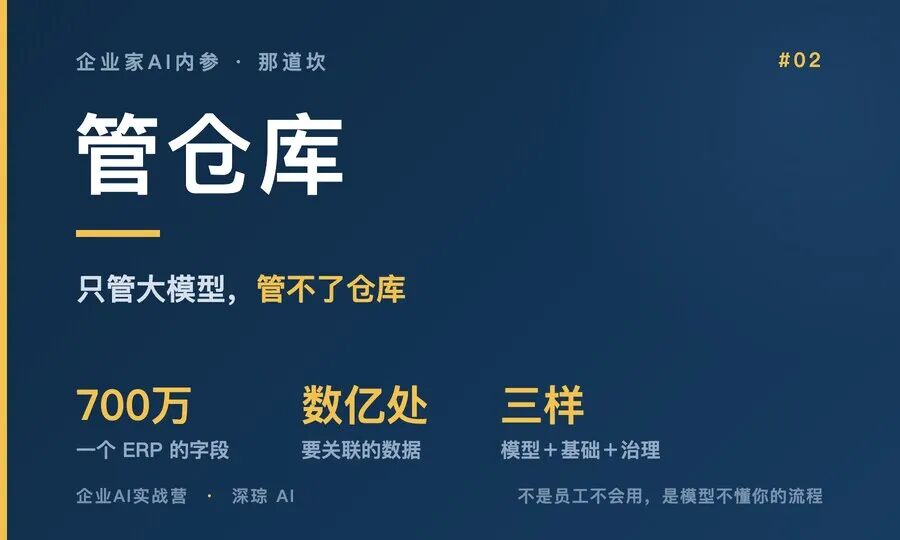
一个 ERP 有 700 万个数据字段,需要关联的数据超过数亿处,才能理解一家企业是怎么运转的。背后还有分行业、分国家的深层流程知识,以及各地的合规要求——SAP 每年为了保持软件合规,要投入数亿欧元。
他们的结论是:可能有一两个小方案流程和数据背景少,可以复制,其余没那么容易。
克莱因的答案因此很直接:大模型旁边必须放上企业自己的 AI 基础——用业务数据和业务流程知识训练,建知识图谱和语义本体层。大模型、AI 基础、治理,三样缺一不可。
他举了个例子。做资产管理,智能体要理解机器发出的传感器信号,判断这台机器什么时候该维护;再把信号和 SAP 的数据配对——生成维修工单、找到能修这台机器的工人、查到备件在哪里,这些还要在时间上接得起来,才能避免停机。
只有一个大模型,做不了这件事。
这也是这句自曝对买方最有用的一点:你买了 AI 发现没解决问题,往往不是员工不会用,是模型压根不懂你的仓、你的单、你的流程。
判断标准就一句:别问 AI 会不会取代你现在的软件,问「我那套系统里,有多少活是不看我的仓、不看我的单就干不了的」。那些活,就是你的软件还活着的原因,也是你要花钱去接线的地方。
节目录制前一个小时,克莱因去拜访了纽约的一家大客户。
对方说:财务结账助手挺好,就是它只有 93% 的准确率。
克莱因当场判断,问题不完全在助手身上——这家公司里散落着上百个财务系统,其中一部分不是 SAP 的。所以第一步不是让 AI 更聪明,是清理房子。
数据质量差、数据孤岛多,智能体再好也会被拖低准确率。
他给的解法是:SAP 和 Databricks、Snowflake、BigQuery 这些数据平台合作,用零拷贝的方式共享数据,不搬数据;在上面做语义层,匹配数据、修复数据质量问题;AI 帮着把 SAP 系统的数据和 Salesforce、Workday 这些系统的数据对上,让智能体可以直接访问开箱即用的语义层。
按他的说法,企业不再需要一支数据科学家大军,每个月把财务、人事、员工、薪资数据来回清洗和对接。AI 擅长做这类匹配,这正是智能体背后正在发生的事。
这里有一处值得留意。主持人问他:数据基础是所有 AI 试点上不了线的常见原因,那越来越聪明的 AI,为什么不能自己解决?克莱因的回答是——AI 本身就会解决这个挑战。
把这两句话放在一起看,就是这件事的真相:AI 能帮你收拾,但「先收拾哪一间」得你自己定。 那上百个系统里,哪套是主数据源、哪套该退休、哪套先接进来,这是管理决策,不是模型能力。
判断标准:你的 93% 里,多少是模型的问题,多少是你自己那一百个系统的问题?
成本已经成了企业 AI 的硬约束。
克莱因说得很清楚:如果员工生产力提高了 20%,成本却涨了 30%,这件事就没有意义。 作为软件公司,要帮客户做的事,是别让客户在庆祝生产力提升的时候,回头发现利润没达标。
SAP 自己就是这么管 token 的。
用 token 最多的那 1% 员工,人均支出在一个月内下降了 9.7%。SAP 的做法是分岗位设上限:对做模型训练的那 1%,不设上限,因为他们的工作直接关系到智能体的准确率;对开发、产品经理、设计师,以及财务、人力岗位,都设了上限,但阈值定得「健康而且公平」,让大家用 AI 做本职工作不会月月撞线。真需要更多,可以申请,由经理审批。
克莱因自己也承认,他拖了一段时间才推这个上限。因为公司一直在对所有人说「用 AI、再培训自己、变得更有效率」,如果他第一个设上限,传出去的信息不是他想要的。
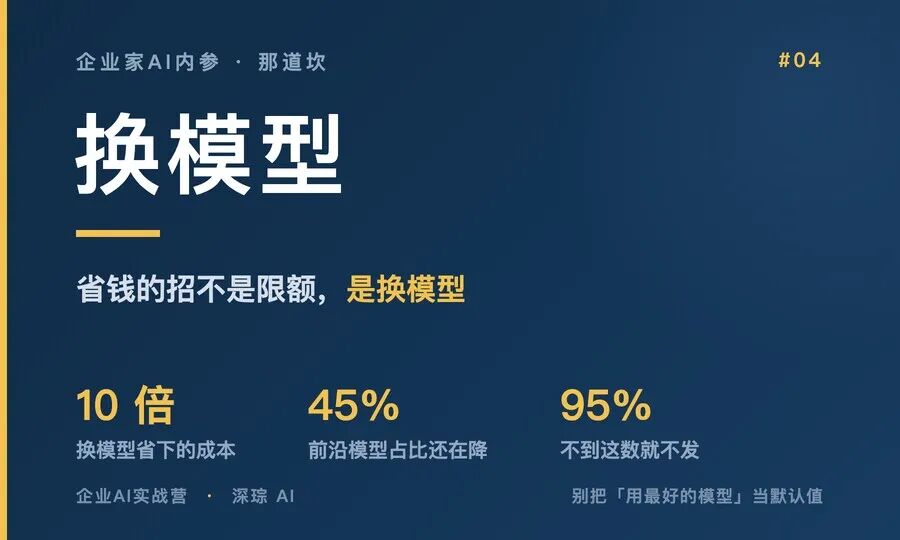
但他说,比上限更有效的,是切换模型:从一个模型换到另一个,成本可以降低十倍。
这组数字能佐证他的话。企业 AI 支出里,前沿模型的占比已经从 53% 降到 45%。克莱因的总结是,标准模型往往是用 10% 的价格换 80% 的性能。
SAP 内部的规矩是:每个要发布的智能体,产品经理都要用不同模型测试,而且要一直做——不少智能体在开发期间已经换到了第五个模型。模型切换本身也快,一两周就能完成,改的是 API,调的是 MCP 服务器。
同时有一条线不许松:准确率到 95% 或更高,智能体才值得发布;客户简报这类,94% 也可以接受。
判断标准:别把「用最好的模型」当默认值。把模型的档位、任务的性质、业务能接受的准确率,三样对上。
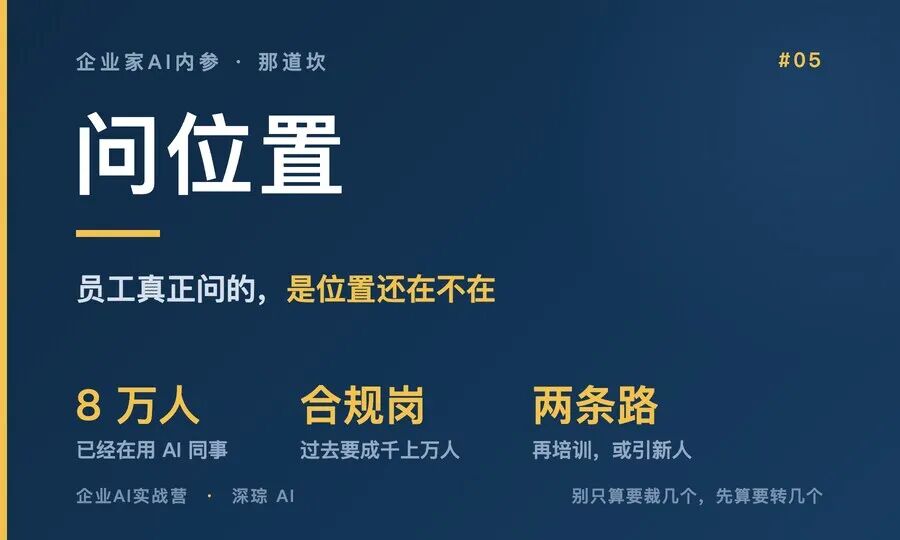
主持人问克莱因:SAP 有十万人上下,员工怎么看这件事?
克莱因说的是全员大会上真正的问题——不是「我会不会更累」,是「我的工作还安全吗?公司会不会重组?」
他没有绕开。他承认很多工作会发生剧变:财务和人力里的各类控制、合规检查,正在被智能体自动化,这在过去是成千上万人的全职工作。
他的判断是:工作类型会变,但不认为会变得更累或更无聊。他自己的经历是,财报发布前材料已经备好,包括他的发言稿,AI 甚至提示他什么时候提高嗓音、什么时候压低,他因此有更多时间想怎么把财报讲好。
岗位会变成不同的组合:公司要招数据科学家、全栈开发人员,其他一些岗位需要更少的人。两条路径并行——一条是对现有员工再培训,另一条是引进带新技能、新思维的人,和老同事搭配起来用。
而再培训最难的,不是技能,是思维方式。
他举了 SAP 自己的例子。公司过去有大批开发人员,写的是本地部署软件;现在要写云软件,方式是 DevOps、代码自动测试、发布上线之后还要负责它稳不稳。这是编码方式的变化,也是思维方式的变化。克莱因说,再培训不只是功能性的技能转换,一个人愿不愿意走进一个新领域,本身就是问题。
他还举了 SAP 自己的 AI 同事 Joule Work:录制节目时约 8 万人在用,但一开始有抵触——「它对我的工作会有什么影响?我到底该怎么用?它真有帮助,还是我最后还是要纠正它做出来的东西?」经过培训和辅导,员工发现事情可以做得更快、精力可以放到更值钱的任务上,才愿意在法务、人力、财务、销售这些部门用起来。
最有意思的是产品经理的变化。过去 50 年,SAP 一直在给软件加客户提的新功能,产品经理不必常去客户那里。现在公司要求产品经理不要坐在公司里,去客户那里——重新设计供应链怎么运转、库存怎么优化、薪资未来怎么处理。
判断标准:别只算要裁几个人,先算要转几个人。员工问的不是「AI 会不会让我更累」,是「我的位置还在不在」——这个题答不上来,办多少场培训都没用。
AI 上不了线,差的不是模型,是签字。
这周先做一件事:
把候选场景分成两类:错了要有人签字的,错了能兜住的。
挑「能兜住」的那一类,两周内先跑出一个小结果。
数一遍:这个场景要接几个系统、几份数据,分别谁在管。
给每个要上线的智能体,定一条准确率红线,写下来。
这条线拖下去,最贵的不是钱,是你团队里那个人先不信了。
你们公司那个 AI 项目,现在卡在哪一步——是技术,还是人?评论区写下来。
转给你们公司正在推 AI 落地的那个人,比收藏更有用