
文|企业AI实战营 栏目《企业家 AI 内参》·第 01 期
云栖大会真正定调的,不是那颗芯片,而是一张 20GW 的电网
9 月 22 日,2026 云栖大会在杭州开幕。
台上,阿里巴巴集团 CEO 吴泳铭没有花时间讲"AI 又帮人写了多少代码"。他讲的是电。
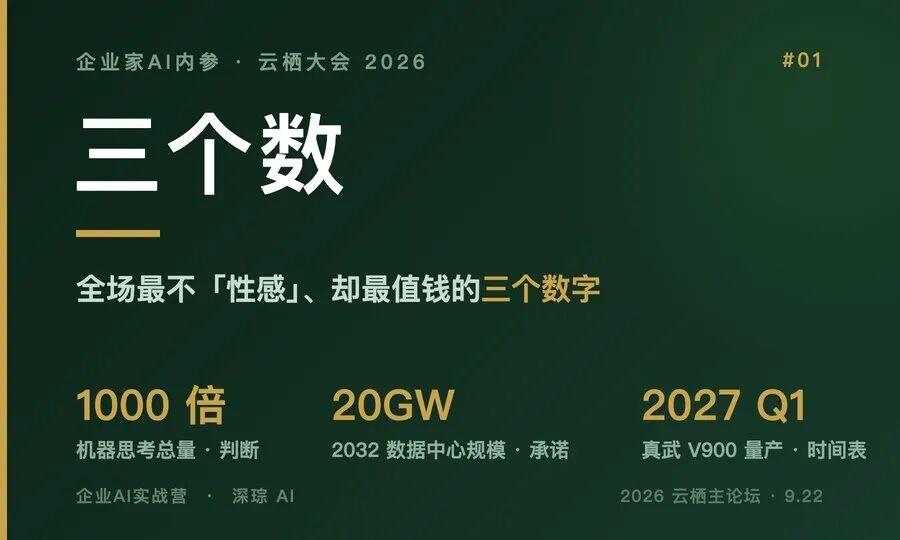
整场演讲里最不"性感"、却最值钱的三个数字是:1000 倍、20GW、2027 年第一季度。
第一个是判断——未来机器供给的思考总量,将达到人类思考总量的 1000 倍以上;
第二个是承诺——到 2032 年,阿里云运营的全球数据中心规模超过 20GW;
第三个是时间表——被称作"中国算力性能最强"的真武 V900 芯片,2027 年一季度量产。
资本市场当天给出了最直接的反馈:阿里巴巴港股盘中一度涨近 5%。但比股价更值得看的是叙事本身。阿里正在要求所有人换一套坐标系来理解它——别按软件公司估,按基础设施估。
一、这场演讲真正完成的,是三次"坐标系切换"
第一次切换:从"谁的模型更强"到"谁的电更便宜"
过去两年,AI 竞争的主战场是模型跑分。这届云栖,吴泳铭把坐标轴换了。
他给的推演链条其实非常短:
机器思考不受人口规模和每天 24 小时的限制 → 需求近乎无限 → 但今天机器的思考总量只相当于人类的约 3% → 前方至少还有几万倍空间 → 所以,在终极产品出现之前,最确定的事是先把发电站和电网建起来。
这套逻辑的关键不在于"1000 倍"这个数字有多唬人,而在于它把竞争变量从"模型能力"挪到了"单位智能的成本"。
阿里自己把话讲得很直白:未来的竞争,就看谁能以更大的规模、更低的价格生产智能。
第二次切换:从"替代人"到"另一个物种"
吴泳铭专门做了一次概念切割。
他认为把 Artificial Intelligence 叫"人工智能"本身就有误导——Artificial 在英文里更接近"人造的",就像人造钻石、人造皮革。行业过去老在问"它像不像人""能不能通过图灵测试",这本质上是一个拟人化的评价标准。
他举的类比是动力革命:蒸汽机、内燃机早期干的是替代人和马的活——矿井抽水、织布、搬运,"马力"这个词就是这么来的。但很快,机器动力能做的事远远超过体力劳动:再多的人和马,也无法让火车飞奔,更无法让飞机和火箭上天。机器动力不是简单的"人造体力",而是创造了完全不同的物种。
同样的推理落到 AI 上,就是那句话:AI 帮人编程、写报告,只是机器智能的初级阶段。
这句话的真正含义是——如果你把 AI 的想象空间定义在"替代现有脑力劳动",你不只低估了它,也低估了阿里这轮下注的尺度。对照一个已经在物理世界发生的事实:今天机器动力已经承担了 99.9% 的物理工作。
第三次切换:从"卖算力"到"卖电"
这是最容易被忽略、但对估值最致命的一次切换。
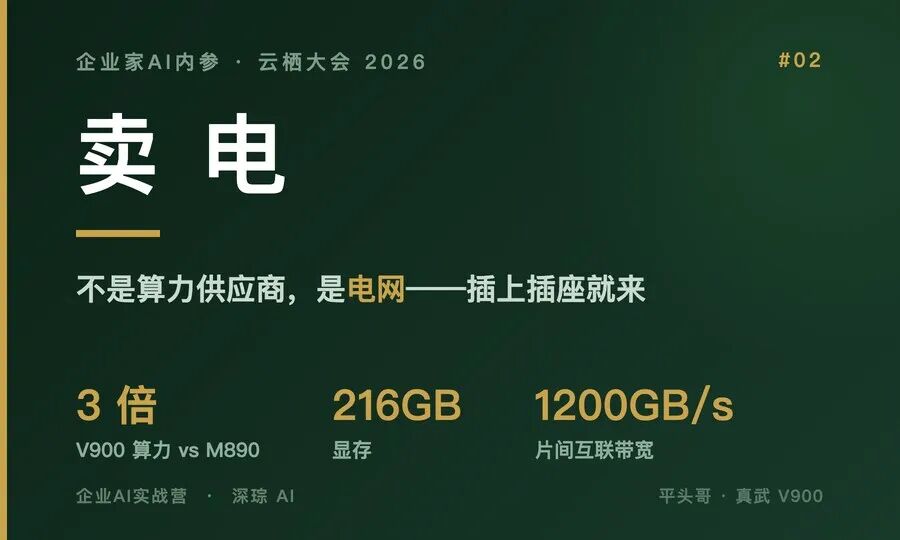
吴泳铭给云的定义不是"算力供应商",而是电网:
今天,我们很少注意到电网本身。在任何地方,只要插上插座,电就来了。如果没有电网和插座,这样的生活恐怕大家连一天都难以忍受。未来使用机器智能,也应该这样方便。
顺手,他还给行业提供了一个新的计量单位——GW。
它已经成了全球云大厂的共同语言。据彭博报道,微软计划到 2032 年把数据中心容量扩至 38GW;AWS 此前披露过一年新增 3.8GW 的节奏。当行业开始用发电站的单位描述自己,这一轮竞争的核心变量就已经不只是模型跑分,而是电力、芯片、土地、网络、资本和工程交付能力。
二、三块拼图:阿里这次到底拿出了什么
基石 | 这次公布了什么 | 关键数字 | 今天能买到吗 |
AI 模型 | Qwen4 已进入训练,Qwen4.5 / Qwen5 参数扩展至 5–10T | RSI 系统连续自主迭代超 1 个月、完成 33 轮 | ❌ 未发布,仅预告 |
AI 芯片 | 平头哥发布真武 V900 | 算力为 M890 的3 倍;216GB 显存;片间互联 1200GB/s;单集群可扩至 50 万卡 | ❌ 2027 年 Q1 量产 |
AI 云 | 给出此前从未对外披露的长期刻度 | 2032 年全球数据中心规模 > 20GW | — |
模型侧,最值得注意的是 RSI——递归式自我改进。按阿里的描述,模型能从真实反馈中发现自己的短板,自己设计实验、构建数据、评价结果,循环推动自身进化。千问新任负责人刘大一恒在这次大会上首次公开亮相,他提到千问的 RSI 系统已持续运行一个多月、累计完成 33 轮有效数据迭代。
他在现场还给了几个具体的证据:Qwen3.8-Max 在人类完全"零参与"的情况下持续迭代超 1 个月;在一颗从未见过的平头哥新款 GPU 上,它自主适配并优化了下代架构模型的推理框架,单实例推理吞吐量提升 96%;在芯片设计上,它仅凭一份真实的总线模块规范就自主展开前端、验证、后端的全链路自迭代,在自主运行超 60 小时、调用 EDA 工具超万次后,完成了减少 42% 面积的物理实现优化。
芯片侧,V900 的参数比"3 倍"这个宣传语更有信息量:216GB 大容量显存、片间互联带宽 1200GB/s、原生支持 FP8 / FP4 低精度计算。平头哥副总裁高慧给了一个很实在的换算——"精度每降一档,一度电换来的 Token 数量基本可以翻一倍"。
同日发布的还有全新磐久超节点服务器,集成 V900、ICN Switch 互联芯片、磐脉智能网卡和镇岳 SSD 主控芯片,实现算、存、网系统级协同。平头哥同时首次公开了倚天服务器 CPU 路线图:2027 年推出倚天 720 与 730。商业化侧,真武系列芯片已服务超 650 家企业,覆盖智驾、金融、具身智能、制造等行业。
云侧,20GW 是这次唯一"此前从未对外披露"的数字。吴泳铭的理由是供给缺口——客户 AI 需求非常强劲,行业中长期需求远超阿里现有供给能力,而 AI 数据中心相关供应链的全球性紧缺,正在限制算力的增长速度。
三、20GW 到底是什么量级
这个数字太大了,大到需要换几个刻度尺来看。
按耗电折算:若 2032 年 20GW 容量满负荷连续运行,一年约 175 TWh。作为参照——2025 年全球数据中心总耗电约 500–557 TWh。也就是说,阿里云一家 2032 年的容量目标,理论耗电约相当于今天全球所有数据中心的三分之一。
按装机对照:2025 年全球数据中心装机(IT power 口径)约 122GW,其中中国约 19.6GW。阿里云一家的 2032 年目标,约等于今天全球的六分之一。
按国内用电量对照:2025 年中国全社会用电量 10.37 万亿千瓦时。175 TWh 约相当于其中的 1.7%。
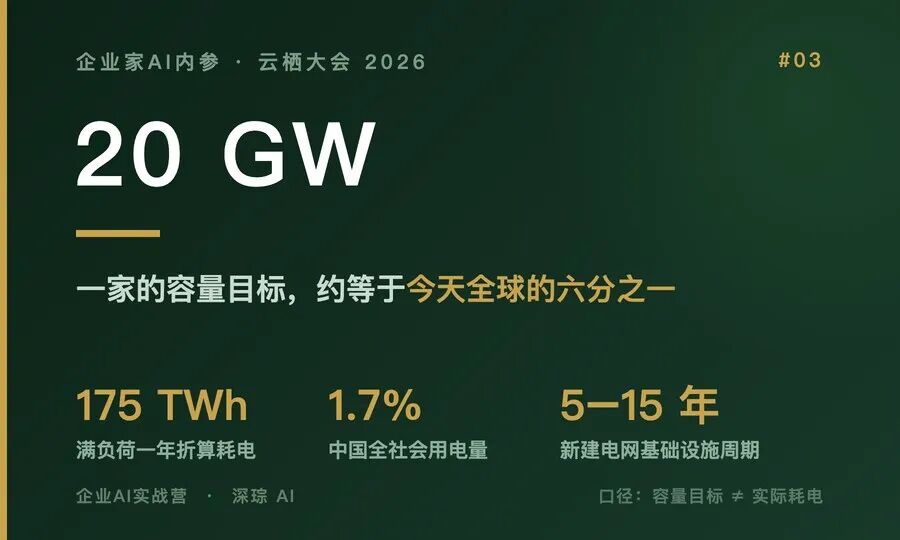
口径提示:20GW 是容量目标,不等于实际耗电。实际值取决于利用率、PUE 和非 AI 负载占比,公开信息均未披露。
但真正的风险藏在同一个数字的另一面:数据中心通常 1–3 年可以建成,而新建电网基础设施需要 5–15 年。 这个时间差,是"20GW"这句话最硬的天花板。
当然,也有人从收入那头算。有分析师按每 GW 对应约 120–150 亿美元年收入估算,到 2032 年阿里云外部收入有望突破 1 万亿元人民币,意味着可能提前实现管理层提出的 2030 年外部收入 1000 亿美元目标。
四、他没说的五件事
如果一篇文章只写"阿里说了什么",那它只完成了一半。以下是这场演讲里一次都没出现的东西:
1)总资本开支和"追加多少",没给。
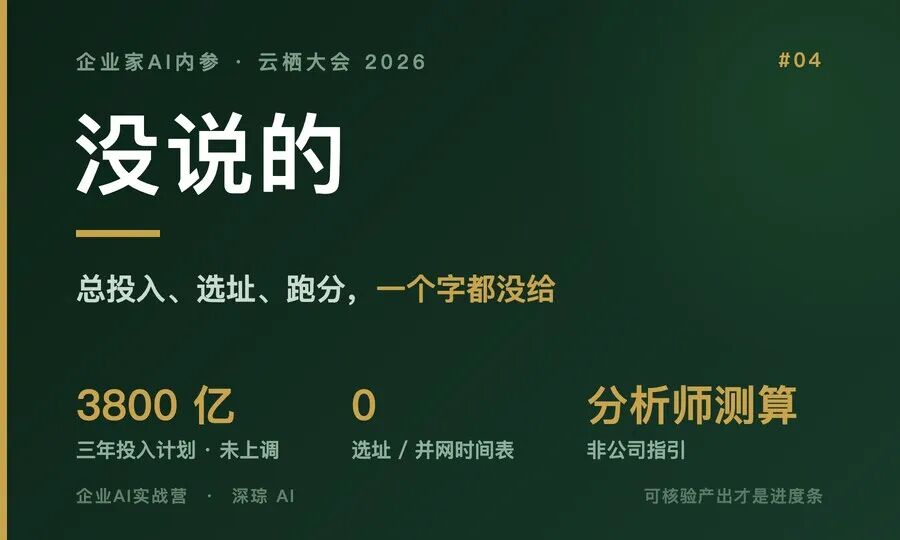
今年 2 月,阿里宣布三年投入超 3800 亿元建设云和 AI 硬件基础设施;截至 6 月底,该计划已累计投入约 1900 亿元。去年云栖,吴泳铭明确说过"将持续追加更大的投入"——但这一次,20GW 对应多大的投入规模、3800 亿计划是否上调、上调多少,一个字都没有。
2)20GW 建在哪、电从哪来、什么时候并网,没给。
这恰恰是整件事里最难的部分。没有选址、没有电力采购协议、没有并网时间表,"20GW"就还是一个意图,而不是一项产能。
3)"3 倍"的独立验证,没给。
目前公开信息里没有第三方基准测试、没有绝对吞吐、没有性能功耗比、没有制程与良率细节,也没有与国内其他加速器的横向对比。"3 倍于 M890"这句话,只有在知道工作负载、精度、软件栈和功耗包络之后才有意义。发布会的形容词,不能替代基准测试。
4)收入测算是分析师做的,不是阿里说的。
"20GW → 上万亿外部收入"来自分析师的线性外推,阿里自己并没有背书这个换算。把长期目标当短期业绩,是这类叙事里最常见的误读。
5)"1000 倍""99.9%"没有任何可验证口径。
这是方向性判断,不是预测。它不需要被证伪,但也不该被当成财务模型的输入。
在宏大叙事和可核验产出之间,后者才是这家公司真正的进度条。 这也是为什么前面那三个工程案例——33 轮迭代、吞吐 +96%、面积 −42%——比 1000 倍这个数字更值得记住:它们可以被第三方核对。
五、和去年比,变了什么
一句话总结这个变化:去年讲的是"我要走到哪里",今年讲的是"我要先花多少钱把路修好"。
顺带一提,这届云栖其实还发布了大量"应用侧"的东西——千问 AI 眼镜 N1 / N1 Pro 与耳夹式耳机(10 月 13 日发售)、千问办公的企业上下文(Enterprise Context)、阿里云 AgentCore 与新一代 CPFS、Qwen-Image-3.1、世界模型 HappyOyster 2.0 Preview、Wan3.0(拿下 Artificial Analysis 文生视频与视频编辑双榜第一)。
这些恰恰在回答"电网建成之后卖什么"。但在吴泳铭的叙事里,它们都是次要的——因为在他的框架里,电器是别人做的,电站才是自己的。
六、这份蓝图,该怎么证伪
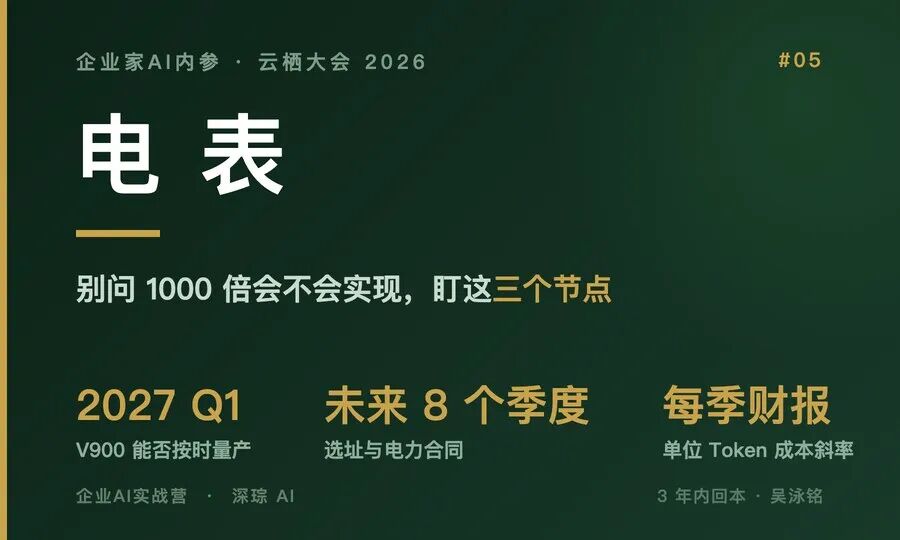
不要用"1000 倍会不会实现"来判断阿里。这个问题没有答案,也不需要答案。真正该盯的是三个可以被验证的节点:
1. 2027 年 Q1——V900 能不能按时量产,有没有阿里云之外的真实客户部署;
2. 未来 8 个季度——20GW 的选址、电力合同与资本开支数字会不会出现在财报和公告里;
3. 每个季度的财报——阿里云收入增速,以及单位 Token 成本的下降斜率。
前两个节点决定这张电网能不能建成,第三个决定它建成之后是不是一门好生意。
吴泳铭此前在财报电话会上给过一个更具体的判断:AI 算力投资可在 3 年内回本,随着毛利提升可能缩短到 2.5 年甚至 2 年。
这句话,比"1000 倍"值得跟踪得多。
结语:电表什么时候开始转
1882 年,爱迪生在珍珠街建起电站,点亮了附近街区大约 400 盏电灯。有意思的是,早期爱迪生卖灯泡是送电的——就像一个多世纪后,Agent 送 Token。
后来发生的事,当时没人能预测。空调要到 1902 年;第一台计算机要等到 1946 年,距离那 400 盏灯已经过去六十多年。吴泳铭用这个类比提醒所有人——今天的 AI Coding,可能只是机器智能时代的"电灯"。
他的结论是:无论后来出现多少新发明,第一步都得先把发电站建起来、把电网铺出去。
这个判断可能是对的。但"可能是对的"和"已经对了"之间,隔着 20GW 的电力、一颗 2027 年才量产的芯片,以及七年时间里不停追加的资本开支。
阿里已经表态:它愿意先付这笔钱。
接下来要看的,是电表什么时候开始转。